De Junior a Senior, el sueldo de referencia crece hasta x3.2.
S/2,500Junior
S/5,000Semi Senior
S/8,000 a másSenior
Fuente: consulta de DSRP a profesionales que trabajan en empresas peruanas, actualizada a octubre de 2026. Montos mensuales en soles.
Referencia oficial: la mediana de «Profesionales TIC y estadísticos» en Perú es S/3,525 al mes (S/2,523 a S/4,997 en la mitad central). INEI — ENAHO 2024 (módulo 500).
Tres pasos para saber si este es tu siguiente rol y por dónde empezar.
1
¿De dónde vienes?
Perfiles que suelen dar el salto a AI Data Engineer:
Ingeniería de sistemas
Desarrollo de software
Soporte y bases de datos
Data Analyst
Ingeniería industrial con base técnica
2
Qué necesitas para empezar
Conocimientos básicos de Python, SQL y GitHub. Es un rol de ingeniería: programar es parte del trabajo diario. Incluye cursos de nivelación asíncronos.
Si nunca programaste, empieza por la especialización Analista de Datos (que no exige programar) o por un curso de fundamentos de Python, y luego pasa a Data Engineer.
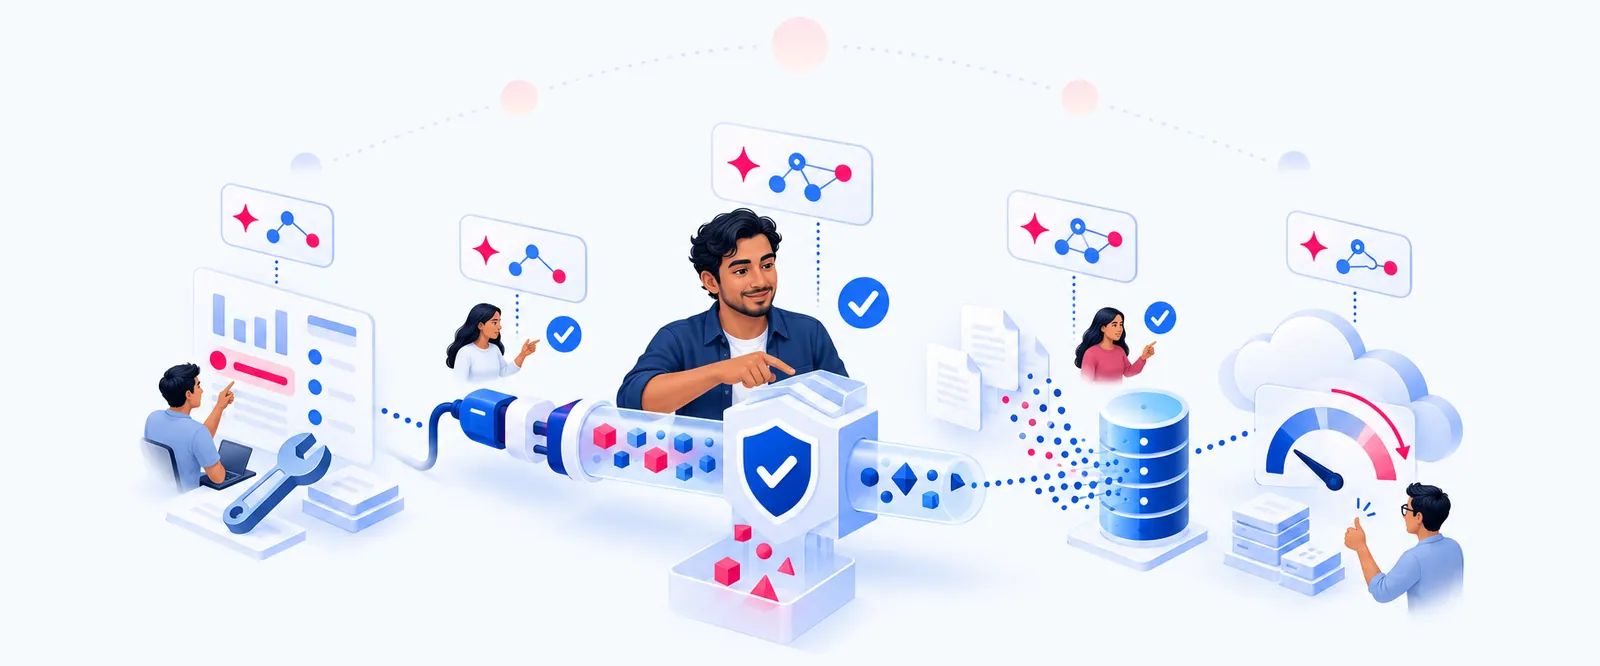
El agente se encarga de lo repetitivo; tú decides qué preguntar, qué aprobar y qué recomendar.
Lo hace el agenteLo decides tú
108:30
Revisión de pipelines
Agente: Resume qué jobs fallaron en la noche y propone la causa probable.
Tú: Confirmas la causa y priorizas qué arreglar primero.
Airflow · logs
210:00
Nueva fuente de datos
Agente: Genera el conector y el código de ingesta a partir de la documentación de la API.
Tú: Revisas manejo de errores, reintentos, costos y seguridad de las credenciales.
Python · Copiloto de código · APIs
312:00
Calidad y linaje
Agente: Propone pruebas de calidad para cada tabla.
Tú: Decides qué reglas son críticas y qué pasa cuando fallan.
dbt · pruebas de calidad
415:00
Datos para la IA
Agente: Divide documentos y genera embeddings para la base vectorial.
Tú: Defines qué documentos entran, cómo se actualizan y quién puede consultarlos.
Embeddings · base vectorial
517:00
Costos y operación
Agente: Reporta el consumo de la nube por pipeline.
Tú: Optimizas lo caro y documentas el cambio para el equipo.
Consola de costos de la nube
Charla gratuita: el AI Data Engineer con IA
Data Engineer 2026: data platforms, IA y arquitecturas modernas. Una sesión completa de DSRP para ver cómo se trabaja el rol con IA antes de decidir.
Qué automatiza la IA y qué no
Lo que delegas al agente
Escribir código de ingesta, transformaciones y pruebas.
Traducir consultas y migrar código entre motores o nubes.
Leer logs y sugerir la causa de un fallo.
Documentar tablas, columnas y pipelines.
Lo que sigue siendo tuyo
Diseñar la arquitectura del pipeline y su modelo de datos.
Garantizar calidad, linaje y seguridad de los datos.
Elegir entre lote o streaming según el caso y el costo.
Revisar el código del copiloto antes de que llegue a producción.
Tu diferencial: datos confiables y gobernados. Un agente es tan bueno como los datos que consulta, y esa base la construyes tú.
Claude · Codex · APIs de modelos
Cómo aprendes a ser AI Data Engineer con agentes de IA
El agente acelera la práctica, pero no hace la tarea por ti. Así lo usas para aprender más rápido sin dejar de entender lo que haces.
El método en 4 pasos
1Pide que te expliqueAntes de pedir código, pide el concepto con un ejemplo de tu área.
2Deja que propongaEl agente escribe el primer borrador: la consulta, el script o el diagrama.
3Verifica túLo corres, lo comparas con la fuente y buscas el error. Ahí es donde aprendes.
4Explícalo de vueltaSi no puedes explicar por qué funciona, todavía no lo aprendiste.
Ejemplo: Le pides a Claude que te explique la diferencia entre una carga completa y una incremental. Claude Code escribe el job que trae las ventas nuevas desde una API. Tú lo corres dos veces seguidas y descubres que la segunda corrida duplica filas porque no hay llave única. Al final explicas por qué la carga debe ser idempotente.
Tu stack de IA en 3 capas
Asistentes de chat
Conversas: explican, resumen y revisan un razonamiento.
Claude
ChatGPT
Gemini
Como AI Data Engineer: Entender patrones como lote vs. streaming o ETL vs. ELT, y comparar opciones de arquitectura antes de construir.
Agentes de código
Trabajan dentro de tu proyecto: leen archivos, corren comandos y proponen cambios que tú apruebas.
Claude Code
Codex
Como AI Data Engineer: Que Claude Code o Codex escriban conectores, modelos de dbt y pruebas en tu repositorio; tú revisas reintentos, credenciales y costo antes de aprobar.
APIs de modelos
Llamas al modelo desde tu propio código: tú decides el prompt, los datos que envías y el costo.
Anthropic
OpenAI
DeepSeek
Kimi
Como AI Data Engineer: Generar embeddings y enriquecer datos dentro del pipeline, con límite de gasto y registro de cada llamada.
Un ejercicio con agentes en cada etapa de la ruta
Bases de datos
Le pides: El modelo de tablas para pedidos, clientes y productos, con sus índices.
Verificas: Las llaves, el tipo de cada columna y el plan de ejecución de la consulta más usada.
Procesamiento
Le pides: Una transformación en Spark o dbt que limpie y una dos fuentes.
Verificas: Que el conteo de filas cuadre antes y después, y que la carga sea idempotente.
Orquestación
Le pides: Un DAG de Airflow con dependencias y reintentos.
Verificas: Qué pasa si una tarea falla a la mitad y si al reprocesar se duplican datos.
IaC y CI/CD
Le pides: El Terraform del bucket y el flujo de CI que corre las pruebas.
Verificas: Permisos mínimos, que nada quede público y que las pruebas fallen cuando deben.
Seguridad
Le pides: Cómo manejar las credenciales del conector sin dejarlas en el código.
Verificas: Que no haya secretos en el repositorio ni en los logs.
Monitoreo
Le pides: Alertas de frescura y volumen para las tablas críticas.
Verificas: Que la alerta salte con un caso simulado y no genere ruido en un día normal.
Proyecto con API
Un pipeline probado que también prepara datos para RAG
Claude Code o Codex generan el pipeline y sus pruebas de calidad; tú los revisas. Luego el mismo pipeline divide documentos, genera embeddings por API y los carga en una base vectorial, con costo y trazabilidad de cada corrida.
Ingestas una fuente pública con un conector que genera el agente y que tú revisas.
Agregas pruebas de calidad: nulos, duplicados, rangos y frescura.
Divides documentos en fragmentos, generas embeddings por API y los cargas en una base vectorial.
Registras de qué documento salió cada fragmento y cuánto costó cada corrida.
Orquestas todo en Airflow, lo pruebas en CI y publicas el código en GitHub.
Modelos cerrados y de pesos abiertos
Claudede Anthropic
Cerrado
Código, agentes que usan herramientas y documentos largos.
Solo por API o planes de pago para uso intensivo.
GPT · Codexde OpenAI
Cerrado
Ecosistema amplio de herramientas e integraciones.
Solo por API o planes de pago para uso intensivo.
DeepSeek
Pesos abiertos
Costo por uso bajo; se puede desplegar en infraestructura propia.
Su API oficial procesa los datos en China: no la uses con datos de la empresa.
Kimide Moonshot AI
Pesos abiertos
Contexto largo y tareas agénticas; también desplegable en infraestructura propia.
Su API oficial procesa los datos en China: no la uses con datos de la empresa.
Cómo elegir
Calidad en tu tarea, medida con tus propios casos de prueba, no con rankings.
Costo por tarea resuelta, no por token.
Dónde quedan los datos y qué retención acepta tu empresa.
Si necesitas pesos abiertos para correr el modelo dentro de la empresa.
Como AI Data Engineer: Para embeddings y enriquecimiento masivo, el costo por documento procesado pesa tanto como la calidad: mídelo con una muestra antes de correr todo. Con documentos internos, usa un proveedor aprobado o un modelo desplegado dentro de la empresa.
IA responsable con datos de la empresa
No subas datos personales ni confidenciales a un chat público sin autorización.
Revisa qué herramientas de IA aprobó tu empresa antes de usarlas con su información.
Enmascara nombres, DNI y montos antes de probar con datos reales.
Toda acción que cambie datos o llegue a un cliente pasa por aprobación humana.
Errores comunes al aprender con IA
Aprobar el código del copiloto sin probar qué pasa si el job corre dos veces.
Dejar credenciales o llaves de API dentro del código que genera el agente.
Generar embeddings de todos los documentos sin medir antes el costo con una muestra.
Cargar documentos a la base vectorial sin registrar de dónde salió cada fragmento.
Saltarte SQL y modelado porque "el agente lo escribe": sin bases no detectas el join que rompe el pipeline.
Tu kit para empezar gratis o casi gratis
Plan gratuito de un asistente de chat (Claude, ChatGPT o Gemini) para conceptos y repaso.
Claude Code o Codex cuando ya tengas un proyecto en marcha: suelen pedir un plan de pago o créditos de API.
Para practicar con APIs, empieza con un modelo de costo bajo y fija un límite de gasto en la consola del proveedor.
Datos públicos para practicar sin usar los de tu trabajo: la Plataforma Nacional de Datos Abiertos o Kaggle.
Una cuenta de GitHub desde el primer día: cada ejercicio queda como evidencia en tu portafolio.
Los planes, precios y límites cambian seguido: revísalos en la página de cada proveedor.
Herramientas y tecnologías del AI Data Engineer
Lenguajes
SQL
Python
Scala
Procesamiento
Spark
Kafka
dbt
Orquestación y DevOps
Airflow
Dagster
Docker
Terraform
Nube y plataformas
AWS
Azure Data Factory
BigQuery
Databricks
Snowflake
IA y agentes
Embeddings
Bases vectoriales
Copilotos de código
Conectores para agentes
Logos de las librerías abiertas devicon y Simple Icons. Las marcas pertenecen a sus dueños.
Sin jerga
Glosario en simple
Los 9 términos que vas a escuchar en este rol, explicados como se los contarías a un colega.
P
Pipeline de datos
Una "tubería" automática que lleva los datos desde donde nacen (ventas, sistemas, archivos) hasta donde se usan, limpiándolos en el camino.
E
ETL y ELT
Extraer, transformar y cargar datos. En ETL se limpian antes de guardarlos; en ELT se guardan primero y se limpian dentro del almacén.
L
Linaje de datos
El "árbol genealógico" de un dato: de qué fuente salió y qué procesos lo cambiaron. Sirve para saber en qué confiar.
O
Orquestación
Programar qué proceso corre primero, cuál después y qué hacer si uno falla, como un director de orquesta.
E
Embeddings
Convertir un texto en números que representan su significado, para que la IA encuentre documentos parecidos.
B
Base vectorial
La base de datos donde se guardan esos embeddings. Es la "memoria" que consulta un agente para responder con documentos de la empresa.
R
RAG
Cuando un agente busca en los documentos de la empresa antes de responder. El Data Engineer prepara esos documentos (embeddings y base vectorial) para que la búsqueda funcione.
M
Multicloud
Saber trabajar en más de una nube (AWS, Azure, Google Cloud). No necesitas dominar las tres: los patrones se repiten y cada empresa suele usar una principal.
I
IaC y CI/CD
Escribir la infraestructura como código y automatizar las pruebas y despliegues, para que todo se pueda repetir sin errores manuales.
Lo que te llevas
Proyecto final
Un pipeline de datos guiado por especificaciones y agentes
Proyecto integrador: requerimiento → especificación → contrato → agente → pipeline → pruebas de calidad. Además, un pipeline end-to-end en Databricks: ingesta → transformación → Delta → consumo SQL.
5 proyectos aplicados con data real
Certificación
Certificación avalada por Data Science Research Perú y el Colegio de Estadísticos del Perú (Región Piura).
5 certificaciones parciales (una por curso) + 1 certificación final.
Empleabilidad
Bolsa de trabajo y pasantías con empresas aliadas.
Elegí la especialización en DSRP para profundizar en automatización, cloud y herramientas como Airflow y Databricks. Lo que más destaco es el enfoque práctico y la experiencia de los instructores. Esta formación fue clave para destacar en entrevistas y conseguir mi nuevo trabajo.
MMateoPasó de Analista de Datos a Data EngineerAlumno/a de este programa
Antes trabajaba como Analista BI, pero necesitaba aprender sobre migración de datos a la nube y herramientas como Databricks y Azure. El temario de DSRP me ofreció un enfoque práctico y profundo. Gracias a esta formación logré un nuevo puesto.
RRenzoEspecialista de Inteligencia Comercial en Compartamos FinancieraAlumno/a de este programa
Terminamos el segundo módulo de la especialización en Data Engineer. Para el laboratorio creamos un clúster de Hadoop en Azure para procesar la información de una fuente transaccional, transformarla en un modelo dimensional y disponibilizarla en Power BI.
JJuan CreadoLíder CoE Data & AnalyticsAlumno/a de este programaPublicado en LinkedIn
¿Aprender solo con IA o con un programa?
Una comparación honesta. Lo ideal es combinar ambos: practicar con agentes todos los días y apoyarte en un programa para la ruta, la revisión y la red.
Solo con IACon un programa
ExplicacionesSolo con IA: Inmediatas, a cualquier hora.Con un programa: Un docente corrige tu razonamiento, no solo el resultado.
ErroresSolo con IA: Dependen de que notes que la IA se equivocó.Con un programa: Especialistas revisan tus proyectos.
RutaSolo con IA: La armas tú; es fácil saltarse fundamentos.Con un programa: Secuencia de los fundamentos a la nube.
ProyectosSolo con IA: Por tu cuenta, sin quien los evalúe.Con un programa: Proyecto integrador y Demo Day.
Red y empleoSolo con IA: La construyes solo.Con un programa: Comunidad, bolsa de trabajo y talleres de CV y entrevistas.
CertificadoSolo con IA: No.Con un programa: Certificación avalada.
CostoSolo con IA: Bajo: planes gratuitos y créditos de API.Con un programa: Una inversión, con cuotas.
Preguntas Frecuentes
¿Qué hace un Data Engineer?
¿Por qué el Data Engineer es clave en la era de los agentes?
¿Necesito saber programar para empezar?
¿Qué herramientas usa un Data Engineer?
¿Qué bases de datos debería conocer?
¿Cómo gano experiencia práctica?
¿Necesito pagar Claude o ChatGPT para aprender?
¿Puedo usar Claude Code o Codex si no sé programar?
¿Puedo usar DeepSeek o Kimi con datos de mi empresa?
Fuente: consulta de DSRP a profesionales que trabajan en empresas peruanas, actualizada a octubre de 2026. Montos mensuales en soles. Detalle por país en datascience.pe/rango-salarial.
 Python
 Scala
 Spark
 Kafka
 Airflow
 Docker
 Terraform
 AWS
 Azure Data Factory
 BigQuery
 Databricks
 Snowflake
 Copilotos de código